
Как дать нейросети анализировать продажи и не показать ей ни одного названия
21 октября 2026
Первое, что служба безопасности крупной компании спрашивает про любой ИИ-сервис: что именно уходит в нейросеть. В Surrika ответ зависит от настройки пространства. Можно отправлять данные как есть, можно заменить все названия метками, а можно спрятать еще и суммы.
Что уходит в нейросеть без защиты
Модель не читает таблицы целиком. Она пишет SQL-запрос, аналитическая база его выполняет, а модель смотрит на результат. Но и при такой схеме данных клиента в обращениях к модели немало.
| Этап | Что видит модель |
|---|---|
| Разбор загруженного файла | Имя файла, первые 60 строк листа и последние 10, значения как есть |
| Ответ на вопрос | Название пространства, глоссарий, описание наборов данных с частыми значениями и строками для примера, результаты запросов до 200 строк, прошлые ответы разговора |
| График | Модель присылает SQL и описание графика, цифры для него считает база |
На последней строке держится вся защита. Цифры на графике модель не рисует сама, поэтому ей не обязательно знать настоящие названия и значения. Достаточно, чтобы запрос был правильным.
Метки вместо названий
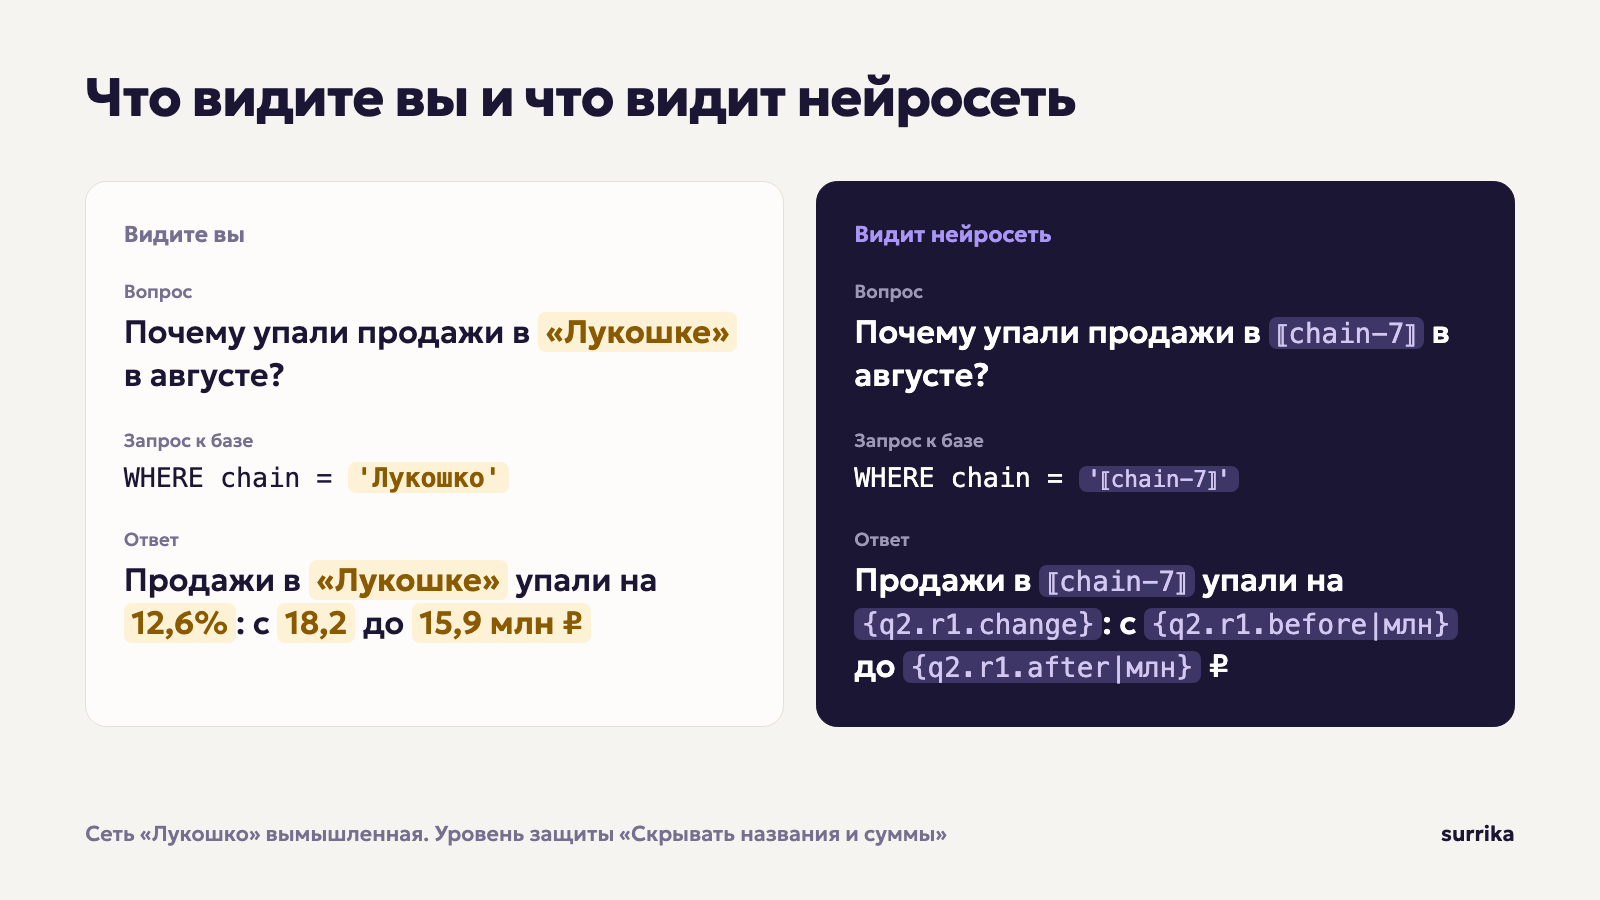
Каждое название в данных получает постоянную метку. Сеть «Лукошко» из колонки chain становится ⟦chain-7⟧, бренд из колонки brand становится, например, ⟦brand-3⟧. Номер метки со временем не меняется. Словарь соответствий хранится только в базе Surrika. Один вопрос проходит так:
- Пользователь спрашивает: «Почему упали продажи в „Лукошке“ в августе?»
- В нейросеть уходит: «Почему упали продажи в
⟦chain-7⟧в августе?» - Модель отвечает запросом с условием
chain = '⟦chain-7⟧'. Surrika подставляет настоящее название и выполняет запрос в своей базе. - Результат возвращается модели с метками вместо названий.
- Модель пишет вывод с той же меткой, и перед показом пользователю метка снова становится «Лукошком».
Падежи при этом учитываются: «в Лукошке», «Лукошка» и «Лукошко» распознаются как одна сеть. Если бренд в данных записан латиницей, а в вопросе по-русски, метка тоже подставится.
Какие колонки прячутся
Прятать все подряд незачем. Каналы, устройства, регионы, категории, дни недели и периоды остаются читаемыми: без них модель не поймет вопрос. Постороннему они ничего не говорят. Колонки с сетями, брендами, производителями, товарами, кампаниями и людьми прячутся автоматически, по названию колонки.
Автоматическое решение можно поменять на странице набора данных, отдельно для каждой колонки. Новая колонка всегда начинает в автоматическом режиме, чтобы про нее не пришлось помнить.
Три уровня защиты
| Уровень | Что видит нейросеть |
|---|---|
| Выключена | Фрагменты данных с настоящими названиями и цифрами |
| Скрывать названия | Сети, товары, бренды и кампании в виде меток ⟦brand-7⟧. Цифры настоящие |
| Скрывать названия и суммы | Метки плюс масштаб: суммы и количества умножены на секретный коэффициент, настоящими остаются только проценты и пропорции |
Уровень выбирается для каждого пространства на странице «Доступ». Так одно пространство агентства может работать с открытыми цифрами, а соседнее, с данными крупного клиента, со скрытыми суммами.
Как скрываются суммы
На уровне «Скрывать названия и суммы» модель получает таблицы, где все суммы и количества умножены на коэффициент. Коэффициент свой у каждого разговора и наружу не уходит. Доли, пропорции и тренды остаются верными, а по абсолютным цифрам масштаб бизнеса уже не понять.
Писать цифры в выводе модель в этом режиме не может. Вместо них она ставит ссылку на ячейку результата, например {q2.r1.revenue|млн}, и настоящее значение подставляет Surrika. Если модель все же напишет число, которого нет ни в одной ячейке, пользователь увидит на его месте прочерк. Заодно модель лишается возможности выдумать цифру, потому что каждое число в ответе взято из результата запроса.
Разбор загруженных файлов
При загрузке модель решает, где в листе шапка, где данные, а где строка «Итого». Самих значений для этого не нужно. С включенной защитой строки над данными сохраняют свои заголовки, ячейки с данными превращаются в метки, которые повторяются там же, где повторяются значения, а при скрытых суммах каждая цифра становится девяткой. Имя файла тоже маскируется.
Что защита не закрывает
Нулевой утечки Surrika не обещает. Пропорции и тренды уходят на любом уровне, потому что без них анализ невозможен. Без названий и масштаба постороннему они говорят мало, но если на ⟦chain-7⟧ приходится 35% продаж, эксперт по рынку может догадаться, что это за сеть. Это ограничение любого обезличивания.
Масштаб защищает от случайного взгляда, криптографии в нем нет. Если в вопросе прозвучит известная цифра, например «план 50 млн», по ней можно вычислить коэффициент. И все, чего нет в данных, уходит в вопросе как есть: названия конкурентов, акций, фамилии, опечатки.
Еще одна лазейка была бы в самом SQL. Запрос выполняется на настоящих данных, и модель теоретически могла бы выведать название по буквам, спросив длину строки или первый символ. Поэтому при включенной защите запрос проверяется до выполнения. Функции, которые разбирают строку на части, запрещены, а поиск по шаблону работает только с метками.
Как это проверяется
Перед отправкой каждое обращение к модели проверяется на слова из данных клиента. Если такое слово нашлось, запрос не уходит, и пользователь видит, что его остановила защита данных.
Качество ответов проверяется на контрольных вопросах с известными ответами. Набор прогоняется с защитой и без нее, после чего журнал обращений к модели проверяется на значения из словаря. Их там не должно быть ни одного.
Для компаний, которым нельзя хранить выгрузки в облаке сервиса, есть коробочная версия. Она разворачивается на серверах компании, выгрузки и база остаются в ее контуре, а нейросеть подключается у российского провайдера. Защиту в облачной версии можно попробовать на своих выгрузках в пробный период. Чтобы и разбор файлов шел с метками, уровень стоит выбрать до первой загрузки.